
AI大模型下的高性能网络
2024年12月26日1 分钟阅读


近年来,人工智能(AI)技术迅速发展,尤其是AI大模型在各个领域的广泛应用,推动了计算和网络技术的飞速进步。随着AI大模型的规模不断增加,对网络带宽、延迟、可靠性等性能要求也变得愈加苛刻,高性能网络成为支撑AI大模型发展的关键因素之一。
AI大模型概述
AI大模型,通常是指具有大量参数、需要大规模数据集进行训练的深度学习模型。这类模型可以处理复杂的任务,如自然语言处理(NLP)、计算机视觉、语音识别等,且在许多应用中表现出前所未有的性能。例如,OpenAI的GPT系列模型、Google的BERT、Meta的LLaMA等,都属于AI大模型的代表。
AI大模型的训练涉及高强度的并行计算、海量的数据传输以及长时间的训练周期。相较于传统的AI模型,AI大模型的特点是其庞大的参数量(通常达到数十亿甚至数百亿个参数)、复杂的训练过程、以及对计算资源的巨大需求。随着计算能力的提升和海量数据的积累,AI大模型的训练与推理能力不断增强,推动了人工智能技术在多个领域的广泛应用。
高性能网络主流解决方案
为满足AI大模型时代对高性能网络的需求,现有网络技术主要集中在InfiniBand和RoCEv2两种高性能协议上。
InfiniBand网络
InfiniBand是一种高性能的互联网络技术,广泛应用于高性能计算(HPC)和数据中心。其具有低延迟、高带宽、高可靠性和高扩展性等优势,非常适用于大规模并行计算和大数据分析等应用场所。在AI大模型的训练中,IB网络通过高带宽和低延迟的特性,能够有效地解决分布式训练中的通信瓶颈,保证不同计算节点之间的高效协作。
IB网络通过支持RDMA技术,实现数据的直接内存访问,从而大幅减少了传统网络协议中因CPU介入而导致的延迟。其“点对点”通信机制使得数据在计算节点之间的传输更为高效,适用于大规模、低延迟的分布式计算。
RoCEv2网络
RoCEv2是一种基于以太网的高性能网络协议,结合了RDMA技术和以太网架构的优势。相较于IB网络,RoCEv2基于传统以太网架构,具有较好的兼容性和更广泛的应用场景。RoCEv2能够在以太网基础上实现RDMA,提供接近IB网络的低延迟和高带宽。
RoCEv2的优势在于其与现有以太网基础设施的兼容性,能够利用现有的以太网交换机和路由器,降低基础设施的建设成本。同时,RoCEv2也支持低延迟、高带宽和高可靠性,适合用于AI大模型训练中的高效数据传输。
飞速(FS)InfiniBand网络解决方案
InfiniBand网络需要专用的InfiniBand光模块和线缆来实现交换机与交换机、交换机与网卡(NIC)之间的连接。飞速(FS)的InfiniBand光模块和线缆经过高度优化,功能丰富,旨在满足现代数据中心和HPC环境的严苛需求。这些光模块速率涵盖40G到800G,并支持多种封装形式,如QSFP+、QSFP28、QSFP56和OSFP,非常适用于InfiniBand网络和英伟达(NVIDIA)GPU加速的HPC端到端系统,确保高效稳定的网络连接和数据传输。
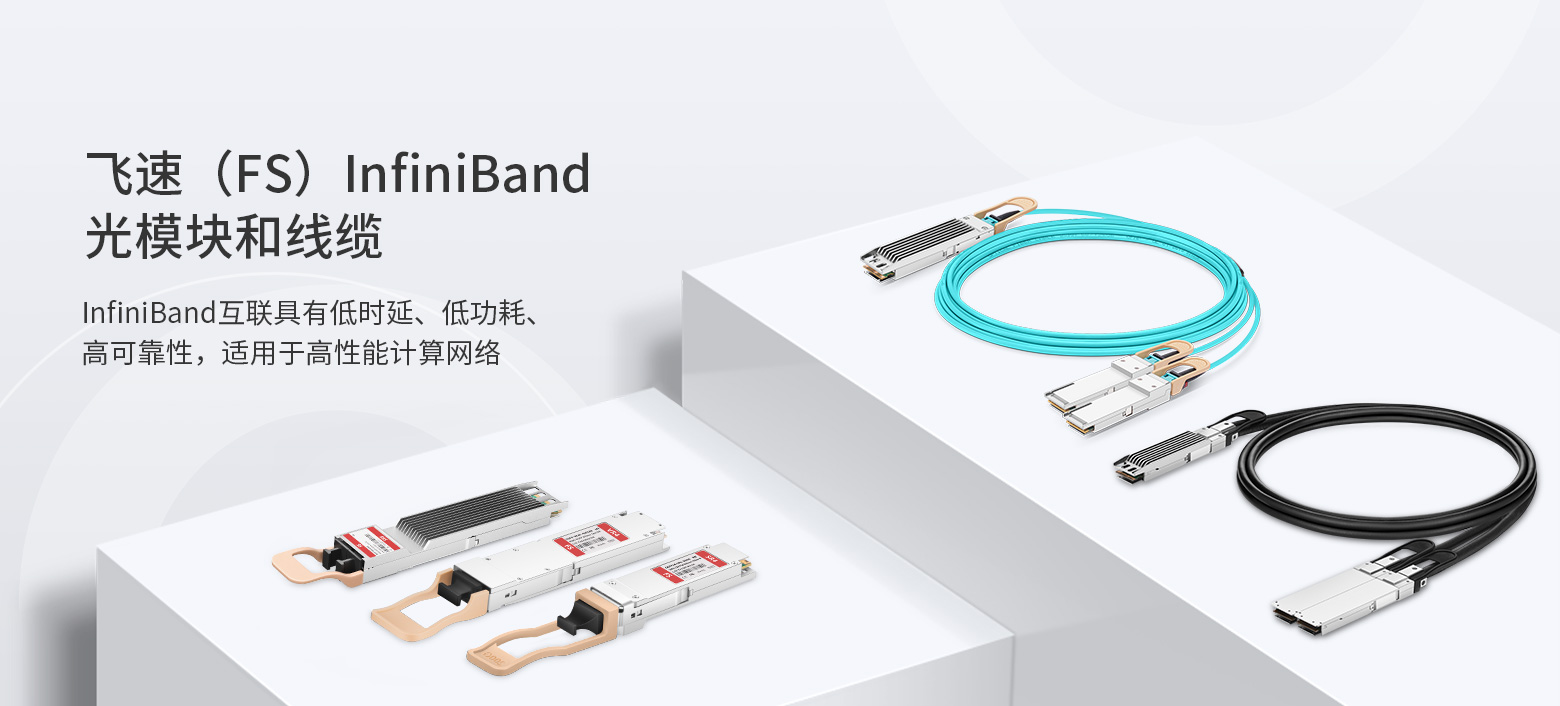
对于以太网高速率网络,飞速(FS)提供与思科(Cisco)、Arista、戴尔(Dell)、瞻博(Juniper)等品牌设备兼容的高速率200G/400G/800G光模块和线缆,支持多种传输速率,包括SR4、SR8、DR4、LR4和ER8等,满足不同网络需求。
结论
随着AI大模型的发展,网络作为AI训练和推理的重要基础设施,已成为决定性能的关键因素。要满足AI大模型对高性能网络的需求,必须依赖于低时延、高带宽、零丢包以及大规模组网能力的高性能网络技术。InfiniBand网络和RoCEv2网络凭借其出色的性能,成为AI大模型训练的首选技术。飞速(FS)作为全球领先的信息通信技术(ICT)产品及解决方案提供商,提供高性能网络解决方案,为AI大模型的高效训练提供了强有力的支持,推动了AI技术的不断进步与应用落地。