
專為下一代高性能AI工作負載而打造
該解決方案專為英偉達(NVIDIA)B300 和Quantum-X800 InfiniBand平臺設計,提供可靠的高性能光模組和高密度光纜基礎設施。憑藉經過驗證的互操作性、低功耗和低誤碼率,它可確保AI工作負載的長期穩定運行,同時為數據中心網絡未來AI基礎設施的擴展做好準備。
- 利用1.6T光連接釋放GPU的全部性能
- 為下一代AI訓練提供海量帶寬
- 用於GPU間通信的超低延遲架構
- 為可擴展的AI基礎設施提供高密度光連接
解決方案設計與服務流程
飛速(FS)提供端到端的解決方案服務流程——從規劃設計到驗證、部署和運維——幫助客戶高效構建穩定且可擴展的網絡基礎設施。
規劃與設計
專家團隊進行深入調研,充分了解您的業務需求。
測試與合規
飛速(FS)產品符合嚴格的全球合規標準,並經過 100% 測試。
交付與集成
專業團隊確保快速高效的交付和集成。
管理與運維
藉助PicOS®和AmpCon,構建靈活安全的網絡環境。
售後支持
全天候 (5×24) 技術支持和維護,讓您安心無憂。
規劃與設計
專家團隊進行深入調研,充分了解您的業務需求。
測試與合規
飛速(FS)產品符合嚴格的全球合規標準,並經過 100% 測試。
交付與集成
專業團隊確保快速高效的交付和集成。
管理與運維
藉助PicOS®和AmpCon,構建靈活安全的網絡環境。
售後支持
全天候 (5×24) 技術支持和維護,讓您安心無憂。
飛速(FS)解決方案服務優勢
智能解決方案設計
飛速(FS)基於客戶的工作負載和AI基礎設施需求,提供專業的網絡架構規劃和產品選型服務,構建可擴展且高性能的AI計算平臺。
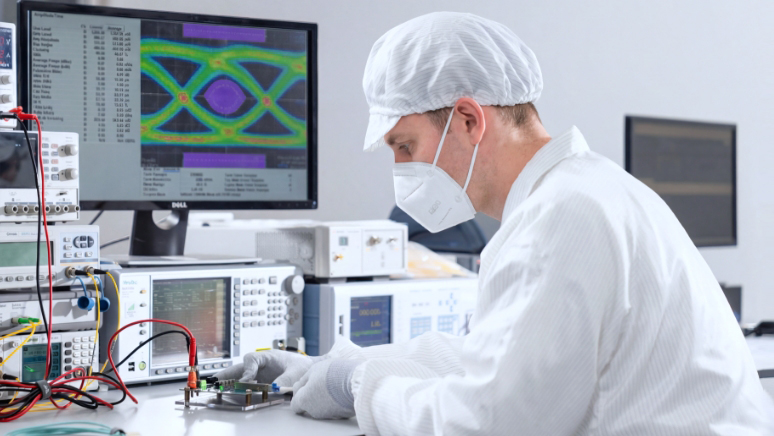
快速部署與可靠性驗證
憑藉先進的測試環境和成熟的交付能力,飛速(FS)在部署前確保兼容性和性能驗證,同時實現快速集成和網絡快速部署。
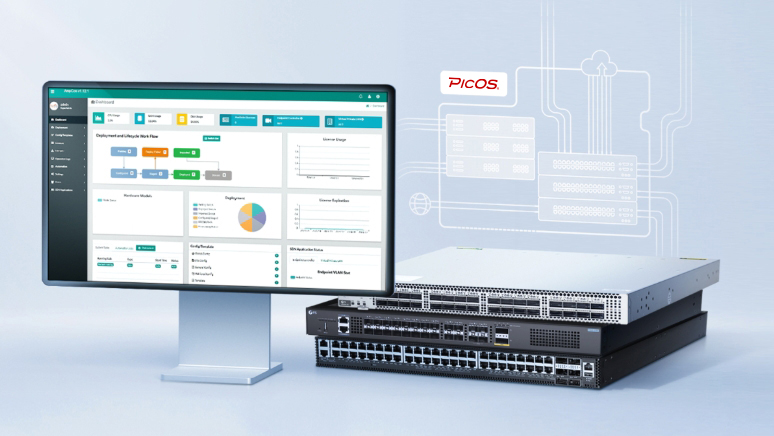
智能網絡運維
飛速(FS)採用PicOS®和AmpCon平臺,實現智能網絡管理和自動化運維,確保存儲和管理網絡的長期穩定運行。
智能解決方案設計
飛速(FS)基於客戶的工作負載和AI基礎設施需求,提供專業的網絡架構規劃和產品選型服務,構建可擴展且高性能的AI計算平臺。
快速部署與可靠性驗證
憑藉先進的測試環境和成熟的交付能力,飛速(FS)在部署前確保兼容性和性能驗證,同時實現快速集成和網絡快速部署。
智能網絡運維
飛速(FS)採用PicOS®和AmpCon平臺,實現智能網絡管理和自動化運維,確保存儲和管理網絡的長期穩定運行。
面向B300 AI集群的1.6T光互連解決方案
產品清單
解決方案部署的優勢與價值
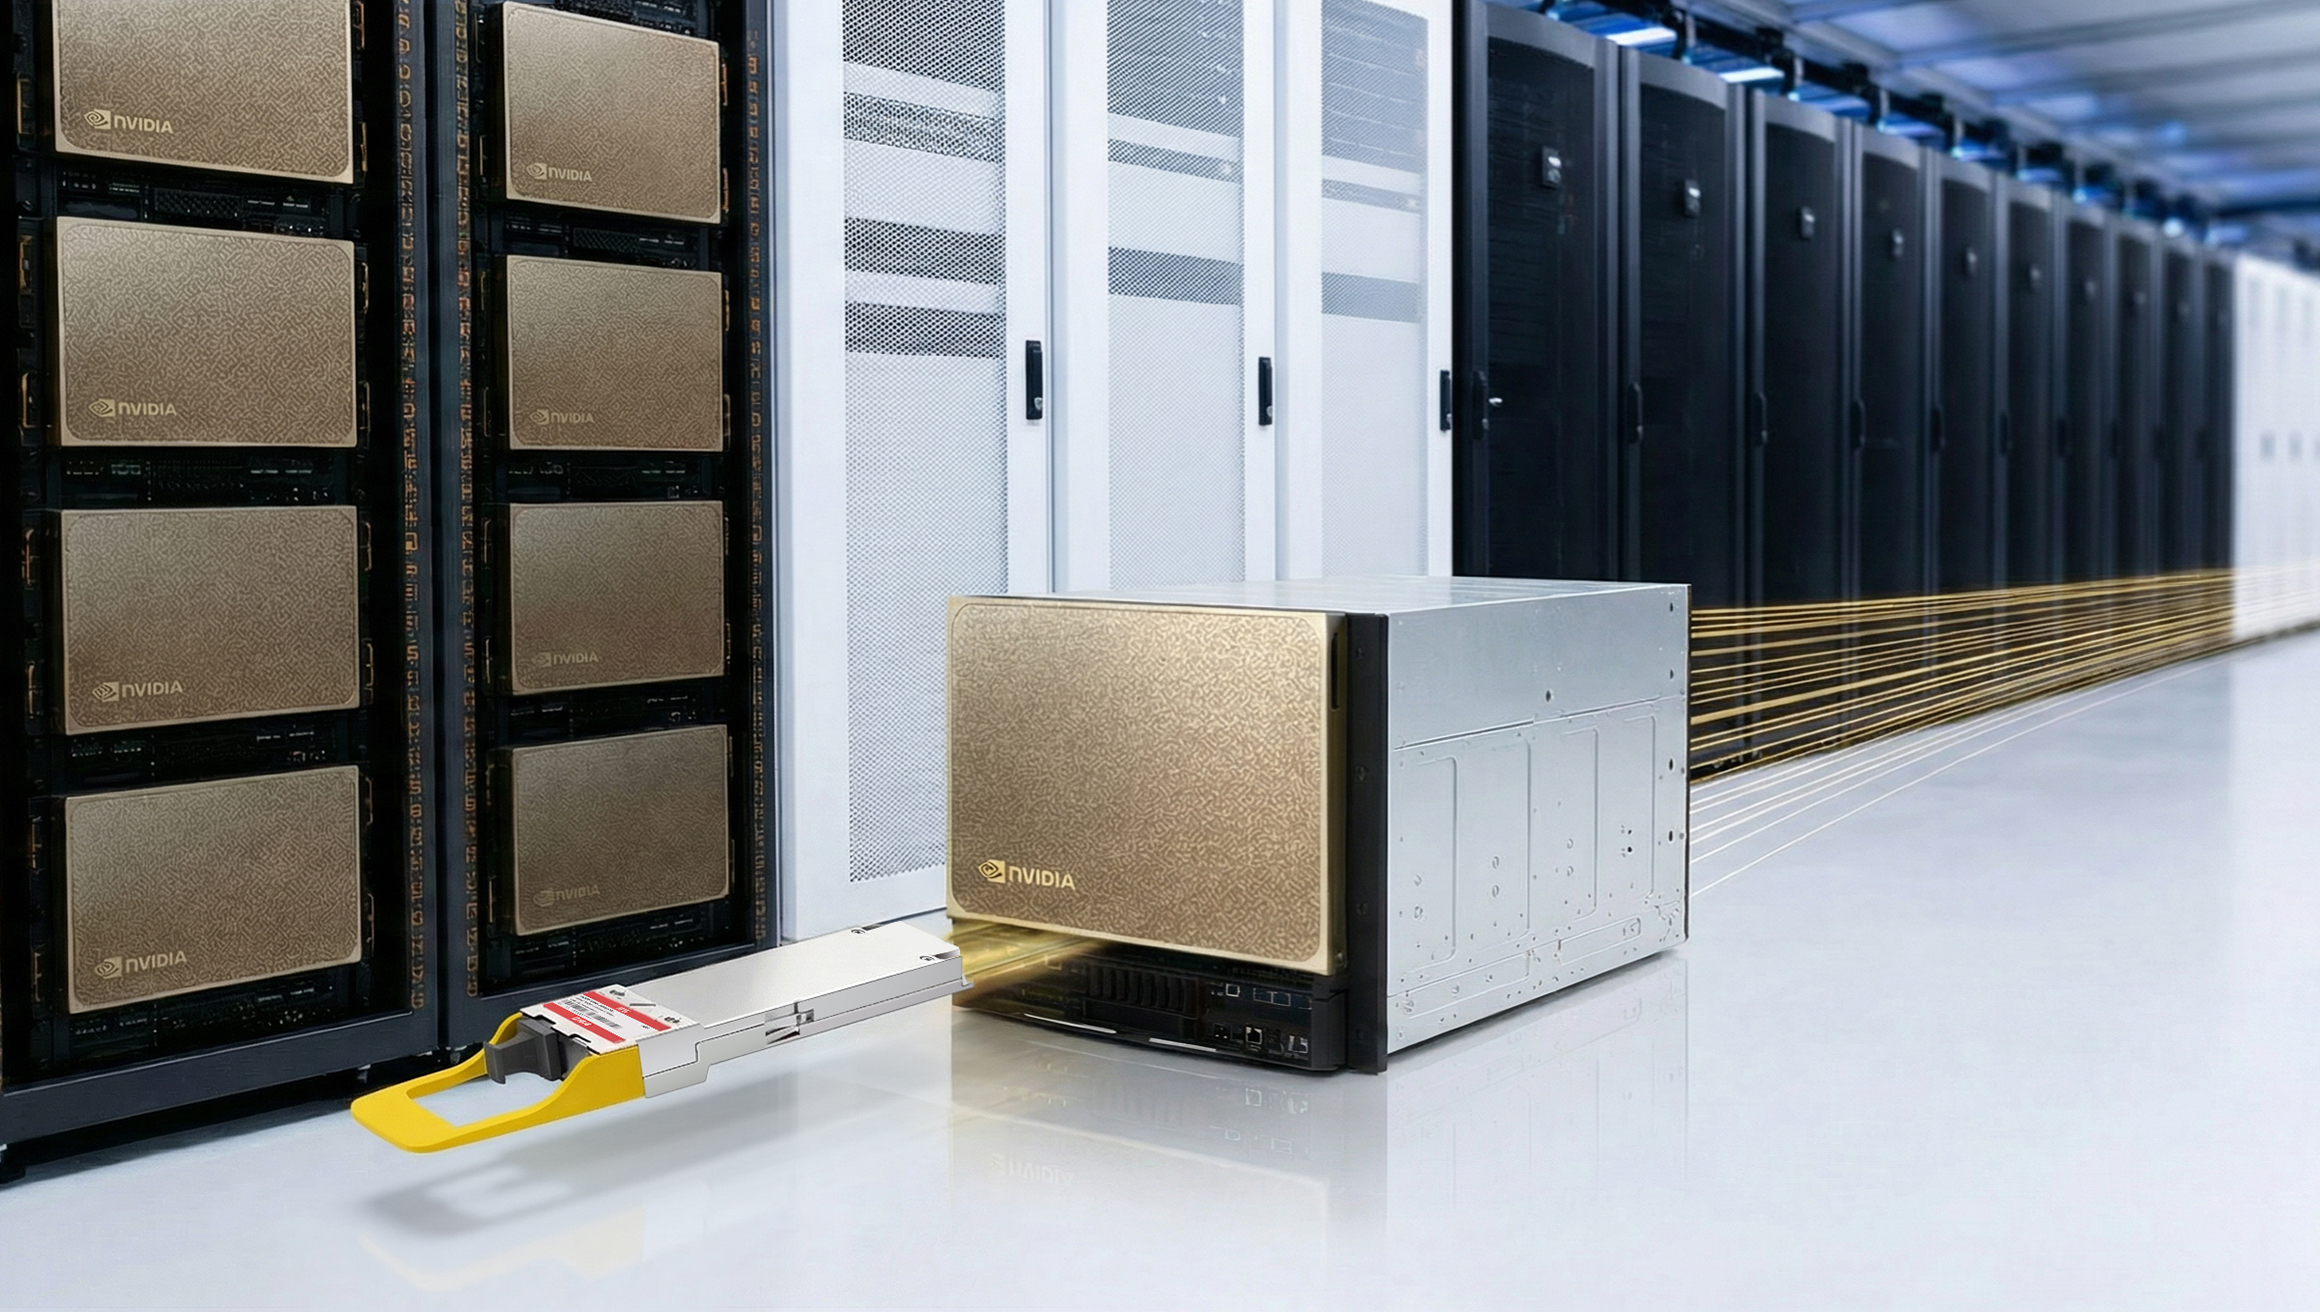
提升計算集群效率
- 1.6T光模組提供超高帶寬連接,加速GPU集群間的數據交換,並最大限度地減少計算空閑周期。
- 該光模組採用Broadcom 3nm DSP和硅光子技術,確保為高要求的AI工作負載提供穩定的性能。
- 這些光模組經過與英偉達(NVIDIA)原裝設備的嚴格測試,確保無縫互操作性和長期可靠性。
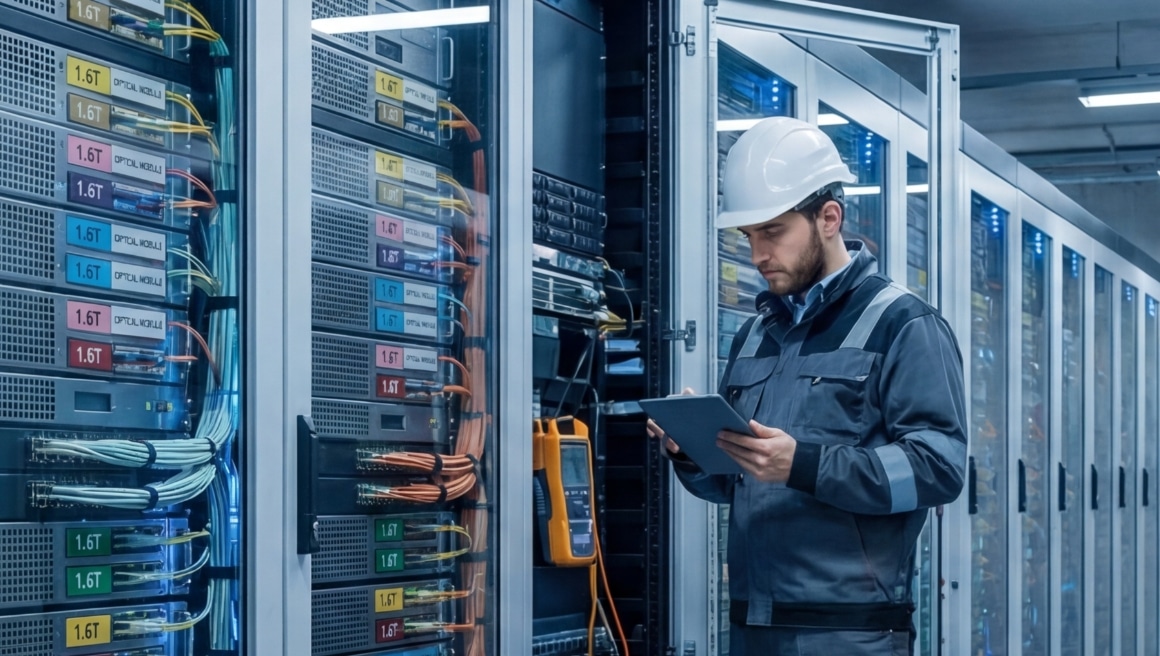
降低基礎設施成本,加快部署速度
- 1.6T光模組使每個端口的帶寬翻倍,每個機架最多可減少50%的交換機數量和60%的線纜數量,從而降低成本並簡化網絡架構。
- 它與現有的800G布線基礎設施完全兼容,可最大限度發揮先前投資的價值。
- 即插即用部署,無需重新布線即可快速擴展容量。
PicOS®確保網絡運行穩定安全
統一的PicOS®可提高運行效率、增強安全性、降低學習和管理成本,並簡化版本管理和升級流程。
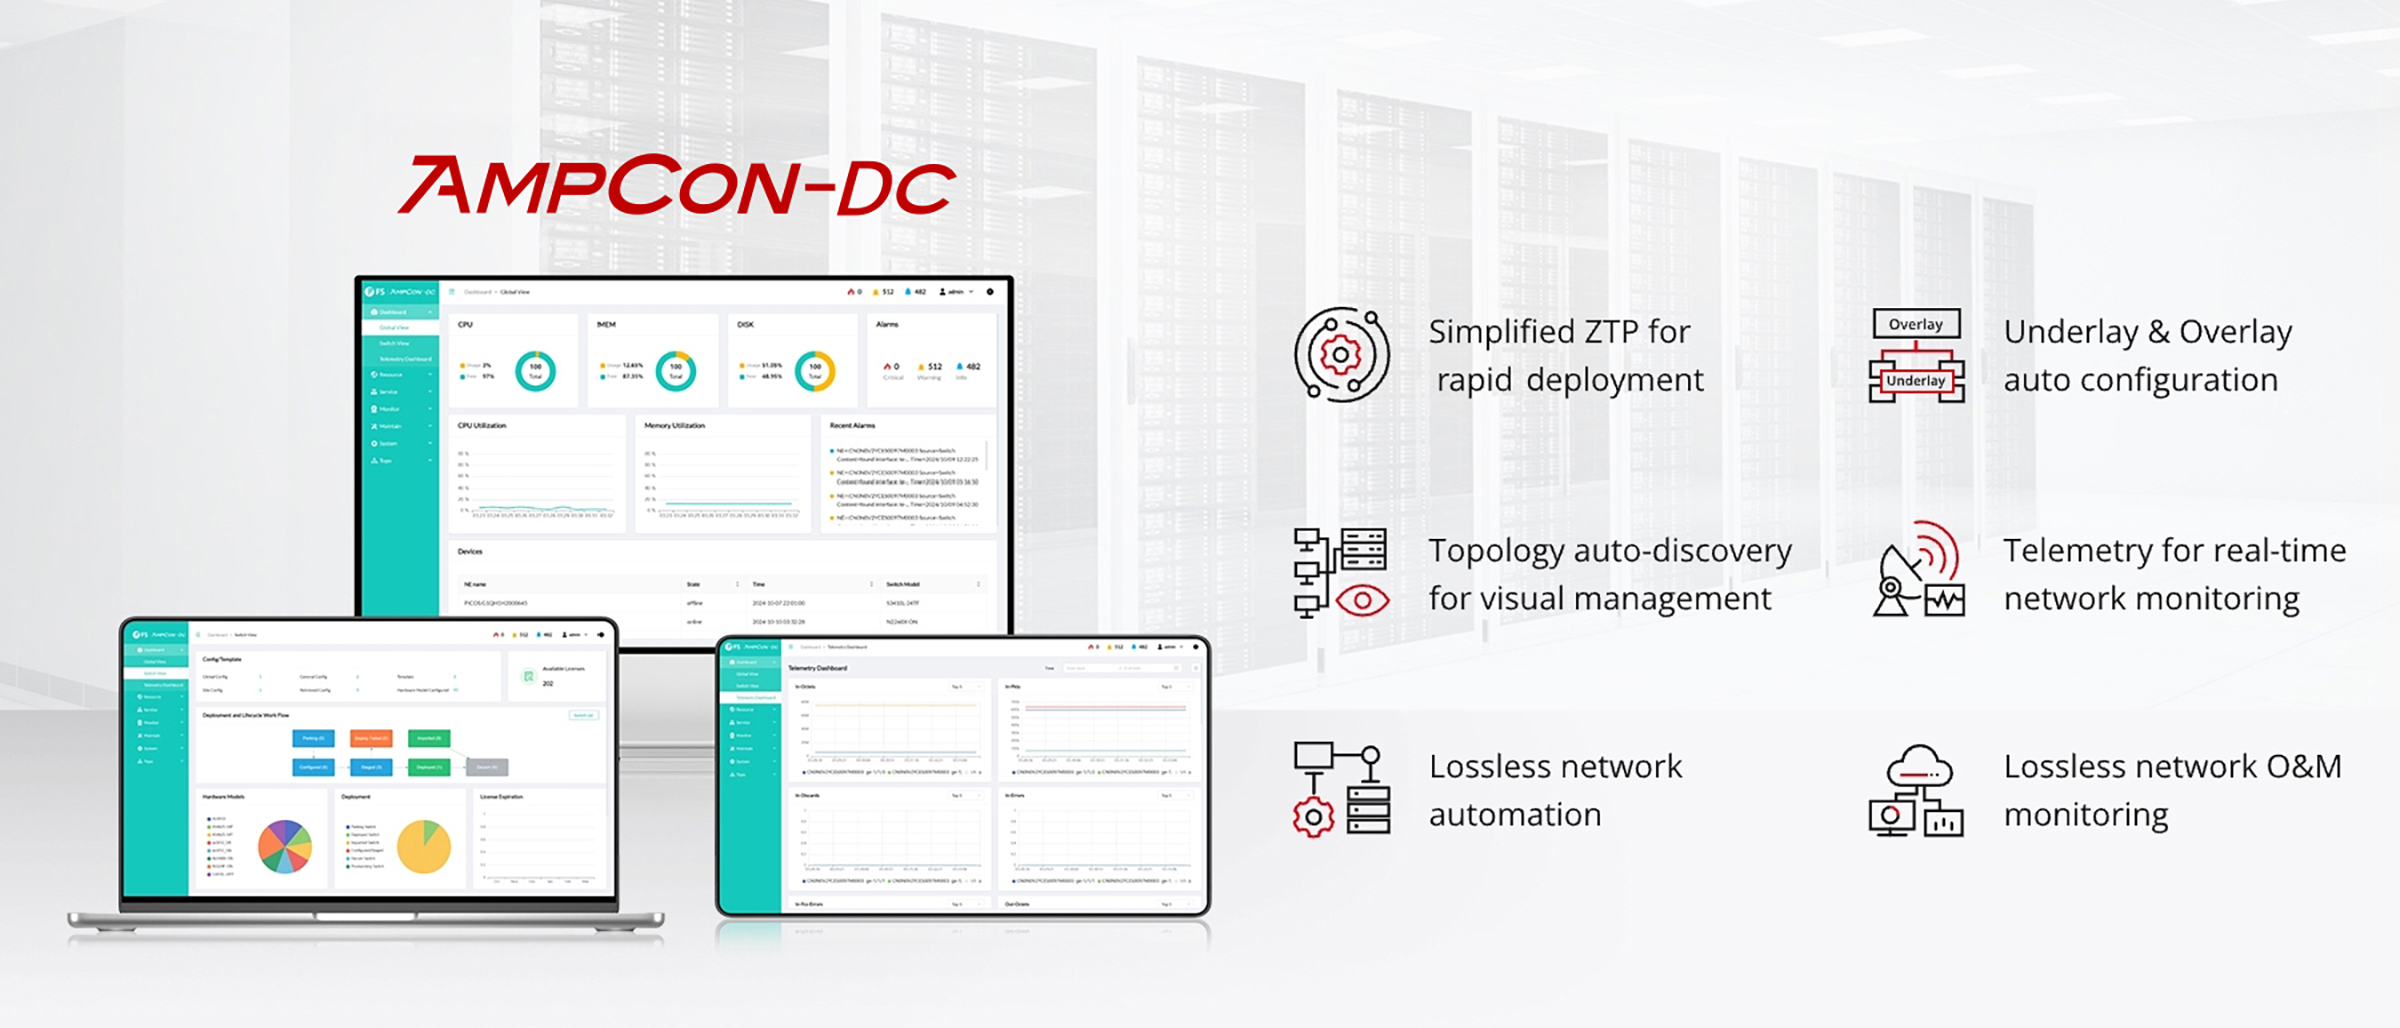
AmpCon-DC自動化配置和統一管理
AmpCon-DC管理平臺提供從第0天到第2天以上的全流程功能,用於管理PicOS®數據中心交換機,從而實現配置、監控、故障排除和維護,以提高資源利用率並降低運營成本。
支持
FAQs
- 我可以免費獲得關於網絡解決方案的建議嗎?
飛速(FS)提供高價值的產品、解決方案和服務,助您達成目標。您可以點擊「產品與項目諮詢」尋求幫助,或進入您的賬戶中心,在「我的工單」中描述具體問題,以獲取技術專家支持。
- 網絡性能如何影響AI訓練效率?
在大規模分佈式AI訓練中,GPU需要頻繁地同步梯度並交換大量數據。高帶寬、低延遲的網絡可以最大限度地減少通信瓶頸,減少GPU空閑時間,並加快模型收斂速度,最終提高訓練效率,加速AI開發。
- B300 AI集群推薦的網絡架構是什麼?
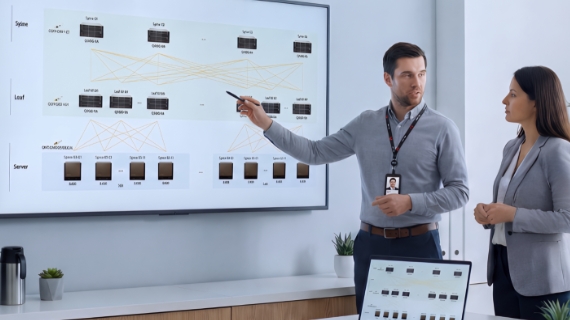
B300 AI集群通常採用無阻塞的InfiniBand葉脊架構,在GPU服務器之間提供高帶寬、低延遲的連接。這種設計能夠實現大規模分佈式訓練環境中的高效數據交換和同步。通過確保網絡性能和可擴展性的一致性,它有助於最大限度地提高GPU利用率,並加速AI訓練工作負載。
- 1.6T光模組是否有與英偉達(NVIDIA)設備進行過測試?
是的。已通過英偉達(NVIDIA)Q3200-RA交換機互操作性測試驗證,確保無縫集成和可靠性能。
- 飛速(FS)能為該解決方案提供哪些驗證和測試報告?
飛速(FS)提供全面的測試和驗證報告,以確保該解決方案在AI基礎設施環境中的可靠性和兼容性。這些報告包括與主流網絡平臺的兼容性測試、高負載下的性能驗證以及基於行業標準的可靠性測試。如需了解更多信息,您可以聯繫您的客戶經理。